AI 데이터·모델 운영 플랫폼 NABIPangeA

범용 ML·LLM을
산업·업무 특화 모델로.

기업의 데이터로 AI 모델을 만듭니다.
수집·정제부터 학습·평가, 모델 배포·운영까지
하나의 플랫폼에서 함께합니다.

도입 문의하기
One

하나의 플랫폼에서
수집·저장·정제부터 학습·평가·배포까지 통합 운영

1위

AI 데이터·모델 운영 플랫폼

국내 최초 데이터 수집부터 모델 배포까지
Data-to-AI 엔드투엔드 제공

Policy-Driven

정책만으로 ML·LLM 학습용
데이터셋을 자동 생성

Proof

추측이 아니라
평가·검증·증명하여 배포

Data Model Service
PROBLEM

고객의 니즈를 해결합니다

AI를 도입하라는데, 정작 우리 데이터는 AI에 바로 쓸 수 있는 상태가 아닙니다.
부서마다 흩어져 있고, 개인정보가 섞여 있고, 형식도 제각각입니다. 외부 GPT에 올릴 수도 없습니다.
그럼 우리는 무엇부터 해야 합니까?

고객의 현실 플랫폼이 없으면
AI 공수의 70~80%가 데이터 준비 엑셀·수작업·일회성 스크립트로 처리 → 기간 내 미완, 품질 검증 불가
망분리·데이터 주권 : 데이터를 밖으로 못 보냄 외부 AI는 못 쓰고, 내부 AI는 데이터가 없어 못 만듦 → 교착
개인정보·감사 : 증빙할 수 있어야 함 출처·가공 이력이 사람 머릿속에만 → 감사 대응 불가, 책임 소재 불명
전문 인력 의존 : 현업이 직접 해야 함 소수 전문가의 개인 스크립트 → 인력 이탈 = 사업 중단 리스크
한 번 만든 데이터를 여러 곳에 재사용 용도마다 따로 준비 → 중복 작업·버전 불일치·품질 제각각
배포가 끝이 아님 : 성능은 저하됨 감지해도 대응 데이터를 처음부터 다시 만들어야 해 대응이 느림
AI를 실험이 아니라 체계로 매 사업마다 데이터 준비를 맨바닥부터 → 일회성 실험에 머무름
AI 결과를 믿기 어려움 사람마다 주관적으로 테스트 → 성능 판단 어려움
모델 품질을 지속적으로 관리해야 함 배포 후 성능 저하를 발견하기 어려움
좌우로 밀면 9가지 현실을 모두 볼 수 있습니다
WHY PANGEA+

하나의 플랫폼으로
Data-to-AI 전 과정을 통제합니다

데이터 중심의 End-to-End 구조
모델 중심 운영도구가 아니라 데이터를 중심으로 수집·정제·학습·평가·재학습을 연결합니다.
AI-Ready Dataset / Golden Dataset
여러 목적에 재사용 가능한 AI-Ready Dataset을 구축하고, 검증된 학습·검증·평가용 Golden Dataset으로 고도화합니다.
동일 데이터 기준 모델 비교
같은 평가셋과 기준으로 기존 모델, 재학습 모델, 신규 모델을 비교하여 객관적인 도입·교체 판단을 지원합니다.
피드백 기반 재학습 선순환
운영 중 축적된 신규 데이터와 오답·피드백을 데이터셋으로 환류하여 평가와 재학습을 반복합니다.
기관 데이터 자산화
데이터셋, 전처리 정책, 모델, 평가 결과, 변경 이력을 함께 관리하여 일회성 산출물이 아닌 지속 가능한 기관 자산으로 축적합니다.
비용·기간 절감 및 재활용
새로운 AI 사업마다 데이터를 처음부터 다시 구축하지 않고 기존의 검증된 데이터셋을 재활용하여 구축 기간과 예산을 줄입니다.
FEATURES

어떤 기능이 있나요?

Collection Studio

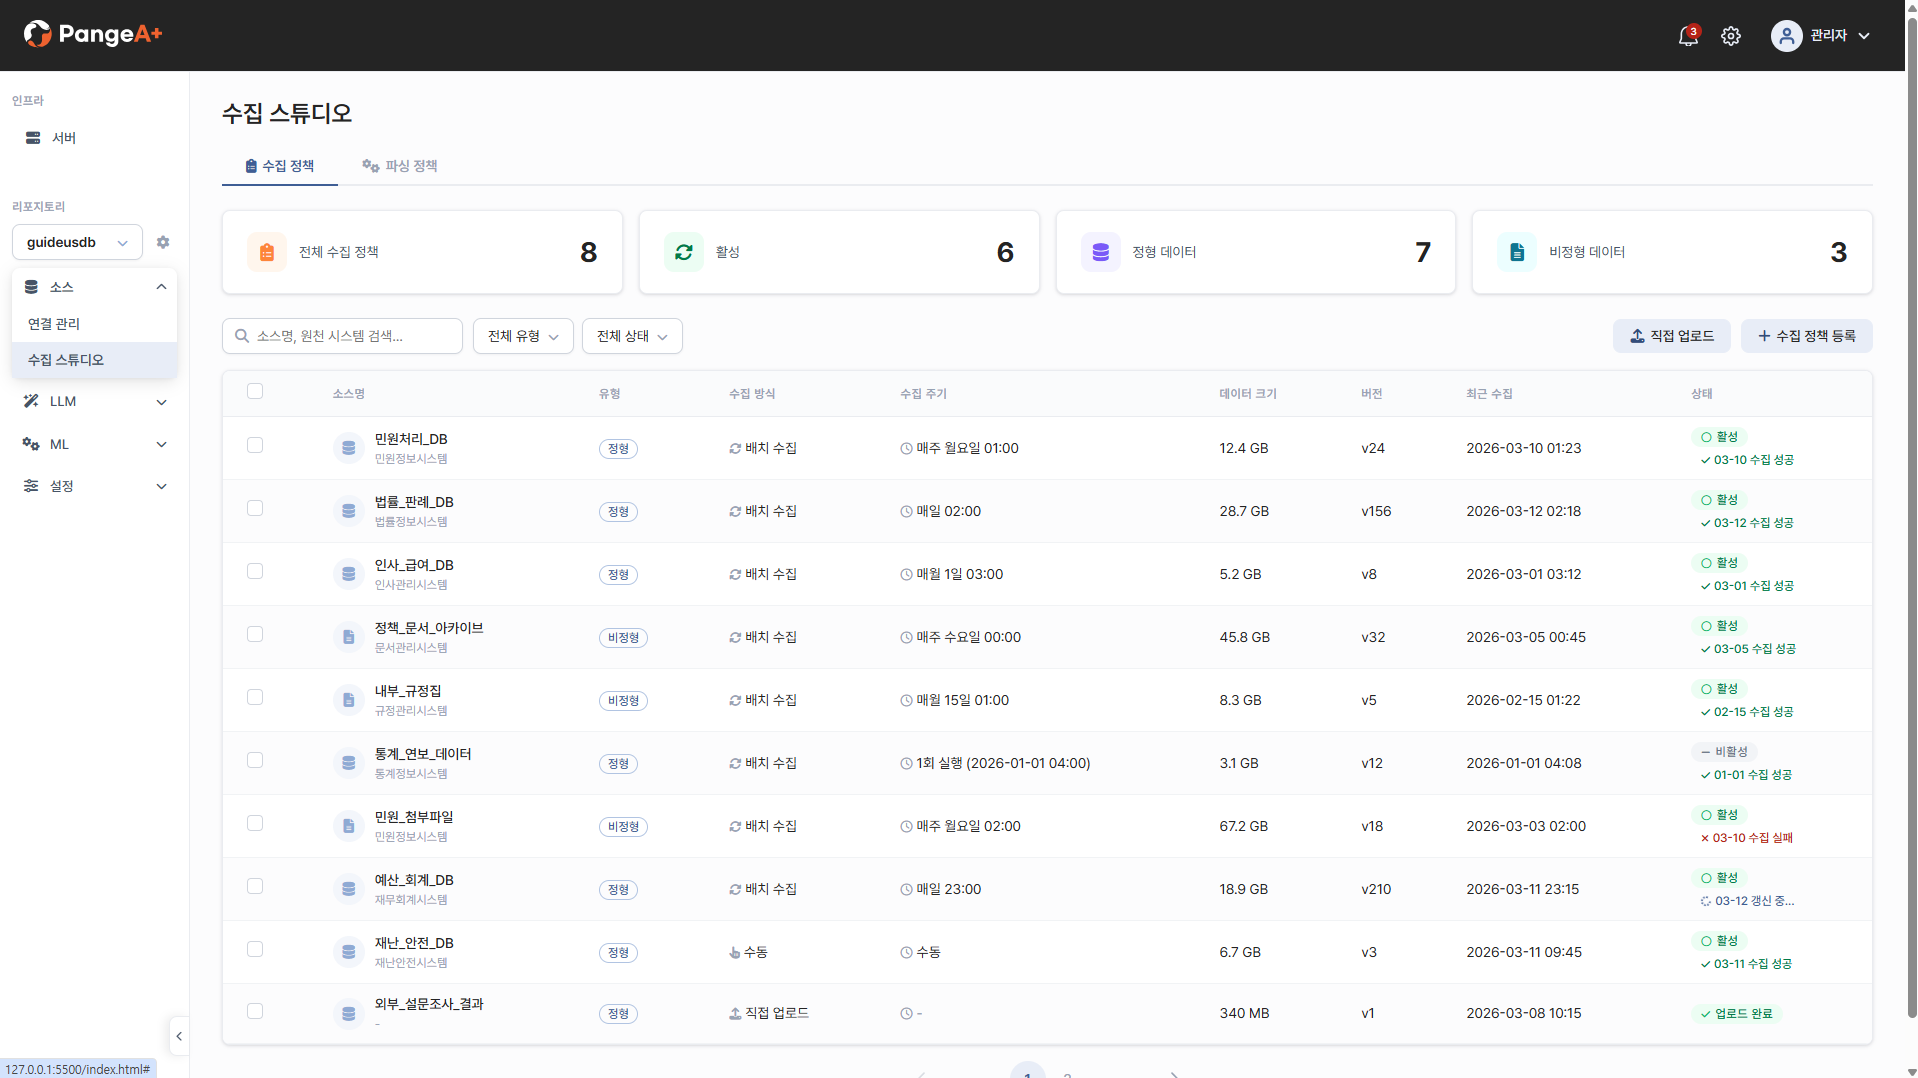
정형·비정형 원천 데이터를 단일 파이프라인으로 통합 수집하여 하나의 SSOT로 정립합니다. 스캔 PDF는 OCR로 자동 판별·처리합니다.

정책 기반 전처리 엔진

ML·LLM을 하나의 엔진에서 처리합니다. 전처리를 코드가 아닌 정책으로 관리하고, Two-Pass로 재현·감사 추적성을 확보합니다.

Data Studio

용도별 템플릿(QA·요약·분류·지시문)으로 AI-Ready 데이터셋을 자동 생성하고, Human-in-the-Loop 검증으로 품질을 보정합니다.

Golden Dataset

여러 AI-Ready 데이터셋을 통합해 학습·평가에 바로 쓰는 최고 품질 Golden 데이터셋으로 완성합니다. Parquet·JSONL·CSV·Arrow로 내보내 주피터·MLflow에서도 그대로 씁니다.

Training (LoRA)

학습→성능 측정→실험 비교→재학습을 하나의 UI에서. LoRA vs Full Fine-tuning으로 최적 전략을 제시합니다.

평가 · 검증 (Playground)

베이스 대비 개선폭(δ)으로 학습 효과를 증명하고, Model Playground에서 실제 대화 A/B로 배포 전 품질을 눈으로 검증합니다.

모델 배포 · 운영

학습한 모델을 레지스트리에 등록하고 추론 엔드포인트(자체 서빙·외부 API)로 배포합니다. RAG·LLMOps 운영까지 같은 플랫폼에서 이어집니다.

NLQ · 시맨틱 모델

예정

정형 데이터를 자연어로 질의합니다. 사람이 정의한 의미 계층 위에서 SQL을 만들고 검증해, 문서 RAG가 답하지 못하는 집계·건수·추이를 정확한 수치로 돌려줍니다.

어시스턴트

사용 중 막히는 순간 화면을 벗어나지 않고 바로 묻고, 답변에 해당하는 실제 화면으로 즉시 이동합니다. 담당자가 바뀌어도 첫날부터 기본 업무를 수행합니다.

Data Lineage

데이터 출처부터 최종 모델 평가까지 8개 계층의 계보를 한 화면에서 추적하고 영향 범위를 파악합니다.

DCAT 표준 관리

Catalog~DataService까지 표준 메타데이터를 SHACL로 자동 검증하고 RDF Turtle로 배포·연계합니다. 자산 등록부터 결재 승인까지 워크플로우로 관리합니다.

인프라 · 보안

단 하나의 선언으로 인프라를 자동 구성하고, 도메인별 완전 격리와 Zero-Trust 기반 접근 제어로 보호합니다.

Q&A

이런 고민이 있으신가요?
NABIPangeA가 답을 드립니다

현장의 고민에 NABIPangeA의 기술력으로 답합니다.

Data-to-AI 자동화 정제·표준화·토큰화·데이터셋 생성을 표준 파이프라인으로 자동화해 바로 학습 가능한 데이터로 만듭니다.
데이터 주권 보장 망분리 내부에서 정제부터 sLLM 학습·RAG까지 외부 반출 없이 해결합니다.
Single Platform, Multi Domain 하나의 플랫폼에서 도메인별 완전 격리된 AI 데이터 워크스페이스를 제공합니다.
감사 증적 자동화 데이터 계보·처리 이력이 자동 기록되어 계보 그래프가 곧 감사 증적이 됩니다.
사업 유형별 적용 sLLM 구축·RAG 지식챗봇·ML 예측·학습데이터 개방까지, 같은 플랫폼에서 중심이 되는 기능만 달리해 수행합니다.
단일 전처리 엔진 ML·LLM을 하나의 엔진, 하나의 정책으로 처리해 완벽한 정합성을 완성합니다.
데이터 생성부터 RAG 운영까지 RAG에 들어갈 데이터를 만드는 단계가 핵심이고, 학습한 모델을 RAG·LLMOps 환경으로 배포·운영하는 것까지 이어집니다. 기존 RAG 솔루션과는 교체가 아니라 함께 씁니다.
One File Infrastructure 단 하나의 선언으로 서버·DB·API·그래프DB·백업까지 전체 플랫폼을 자동 구성합니다.
VectorDB 보완 레이어 VectorDB에 들어갈 청크의 품질·일관성을 보장하고 RAGOps 플랫폼과 연동합니다.
모델 배포·운영 내장 모델 레지스트리와 추론 엔드포인트(자체 서빙·외부 API)를 갖춰, 학습한 모델을 같은 플랫폼에서 배포하고 운영합니다.
No-Code 정책 관리 전처리를 코드가 아닌 정책으로 관리하고, Two-Pass로 재현 가능한 학습 데이터를 만듭니다.
베이스 대비 델타 증명 같은 평가셋을 베이스 모델로도 실행해 개선폭을 수치화합니다 (종합 82.4 ← base 62.8, ▲ +19.6).
실험 비교로 최적 전략 LoRA vs Full Fine-tuning을 비교해 비용 대비 성능이 최적인 학습 전략을 제시합니다.
학습 메트릭 수치화(KPI) Loss/Gap/추이와 Train-Eval Gap 분석으로 AI 리스크를 사전에 관리합니다.
표준 포맷 내보내기 Parquet·JSONL·CSV·Arrow로 내보내 기존 학습 도구에서 그대로 씁니다. 학습 환경을 바꾸지 않아도 됩니다.
자동 생성 + 리니지 추적 정책 기반으로 데이터셋을 자동 생성하고 8계층 계보로 문서부터 데이터셋까지 완전 추적합니다.
Human-in-the-Loop(HITL) 검증 전문가가 검토·보정하는 HITL 프로세스로 신뢰성과 정확성을 지속적으로 향상합니다.
용도별 템플릿 제공 QA·요약·분류·지시문 템플릿을 선택하면 데이터셋 구조와 포맷이 자동으로 구성됩니다.
Impact 분석 문서 하나로 영향 받는 LLM 데이터셋 전체 목록을 한 번에 조회합니다.
에이전트도 학습이 성능을 좌우 Tool-use·Function Calling 정확도, 라우터·분류 모델, 임베딩 파인튜닝, 평가·리워드 모델 — 모두 학습 데이터가 필요한 영역입니다.
End-to-End Lineage 데이터 출처부터 최종 모델 평가까지 8계층 계보를 한 화면에서 추적합니다.
감사 증적 자동화 NABIPangeA 계보 그래프가 곧 감사 증적입니다. 별도 문서화가 불필요합니다.
도메인별 격리 강제 파라미터 기반 논리 격리로 도메인 간 데이터 혼입을 원천 차단합니다.
Zero-Trust 접근 제어 Bootstrap 기반 보안 설정으로 인가된 사용자·시스템만 AI 데이터에 접근합니다.
DCAT 카탈로그 · 결재 DCAT 표준으로 카탈로그화하고 SHACL로 자동 검증합니다. 자산 등록부터 결재 승인·배포까지 워크플로우로 관리합니다.
One File Infrastructure 단 하나의 선언으로 전체 플랫폼을 자동 구성·배포하여 관리 포인트를 최소화합니다.
자동 부트스트랩 컴포넌트가 자기 설정을 스스로 등록합니다. 사람이 연결하지 않습니다.
10~30분 구축 NABIPangeA Installer로 AI 데이터 파이프라인 인프라를 빠르게 구성합니다.
고가용성 · Scale-out Database+API+Streaming 동일 클러스터링과 다중화 구성으로 대량 서비스를 지원합니다.
어시스턴트 막히는 순간 화면을 벗어나지 않고 바로 묻고, 답변에 해당하는 실제 화면으로 즉시 이동합니다. 별도 교육 없이 첫날부터 기본 업무를 수행합니다.
DATA LIFECYCLE

수집부터 배포까지
하나의 플랫폼에서 순환합니다

데이터를 준비하고, 모델을 학습·검증하고, 배포해 운영합니다.
운영에서 쌓인 피드백은 다시 데이터로 돌아와 다음 순환을 더 정교하게 만듭니다.

준비

수집 · 저장 · 정제

흩어진 정형·비정형 원천을 하나의 파이프라인으로 수집하고, 코드가 아닌 정책으로 정제합니다.

학습 · 검증

AI-Ready · Golden · 학습

AI-Ready 데이터셋을 Golden 데이터셋으로 격상하고, 같은 기준으로 모델을 학습·평가합니다.

운영

검증 · 배포 · 서비스

베이스 대비 개선폭을 증명한 뒤 배포하고, 추론 엔드포인트로 서비스를 운영합니다.

운영에서 쌓인 피드백 · 로그가 다시 데이터로

준비하고, 학습·검증하고, 운영하고, 다시 데이터로 돌아옵니다.
이 순환이 반복될수록 AI는 더 정교해집니다.

IMPACT

NABIPangeA 도입 효과

70~90%
신규 모델 출시까지
걸리는 시간 단축
50~70%
데이터 준비시간
단축
10~30분
AI 데이터
파이프라인 인프라 구축
80%+
기존 Feature
재사용율
2~4배
데이터 사이언티스트
생산성 향상
확보
AI 주권 (Sovereign AI)
데이터 수집·거버넌스·카탈로그·학습데이터셋·모델학습

본 수치는 AI 데이터 플랫폼 및 Feature Store 도입에 따른 운영 효율화 효과를 기반으로 산정되었으며, 인프라 구축 관련 지표는 NABIPangeA Installer 적용 환경을 기준으로 산출되었습니다.
[출처] Tecton/Uber Michelangelo case study
[출처] Uber Michelangelo, Airbnb Zipline
[출처] Forrester Total Economic Impact of Modern Data Platforms (2023)
[출처] McKinsey The Data-Driven Enterprise (2022)

지금 시작하세요!

데이터부터 모델까지
하나의 플랫폼에서 완성하세요.

수집·정제부터 학습·평가, 배포·운영까지 하나로 잇는 AI 데이터·모델 운영 플랫폼 NABIPangeA.
추측이 아니라 평가·검증·증명으로 배포합니다.
준비된 데이터가 당신의 범용 AI를 산업·업무 특화 모델로 진화시킵니다.

도입 문의하기